1.产品简介
微生物多样性测序(也称为扩增子测序),是一种利用二代或三代测序平台,以细菌/古菌16S rRNA基因可变区、真菌18S rRNA基因可变区或真菌ITS(Internal transcribed spacer)特定基因区段为靶点,通过检测序列的变异和数量,反映菌群中各类微生物的种类和丰度,从而快速解码菌群物种分布特征,阐明样本间多样性和组成差异。这种技术突破了传统微生物不可培养的限制,能鉴定环境样本中的微生物群落结构、进化关系以及微生物与环境的相关性等信息。
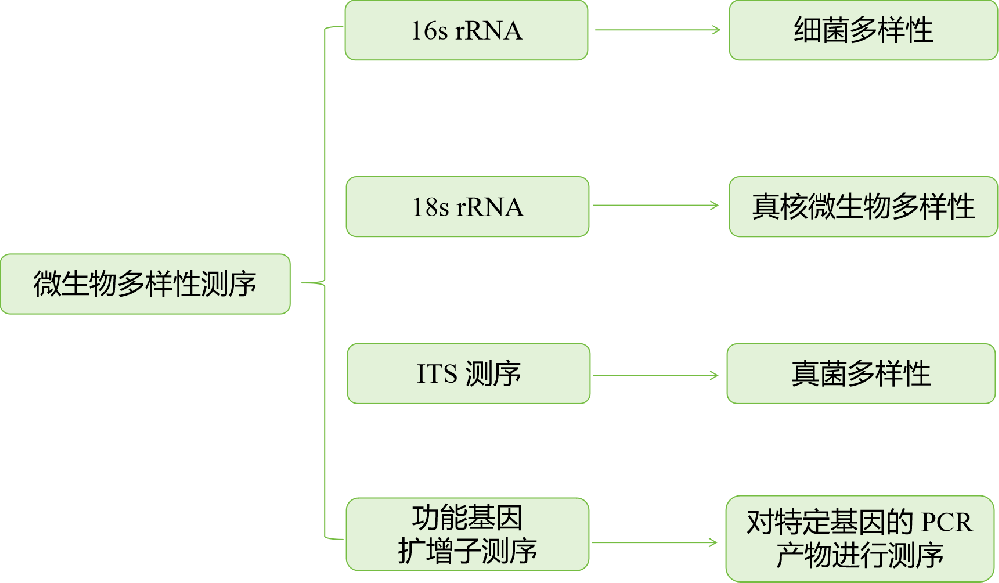
图1:微生物多样性测序分类
1.2三代全长16S扩增子测序
二代16S,由于读长相对较短,只能从9个可变区中选择基因的部分区域(如V3-V4区域、V4区域等)测序,较难区分种水平物种。随着测序技术的发展,三代测序技术被应用到16S扩增子测序中。康圣序源基于PacBio Revio测序平台的三代全长16S测序技术,读长更长,覆盖V1-V9区域,可直接获得16S全长序列,突破了二代16S测序读长短的局限性,实现低丰度的物种检测、提高物种注释准确性和分辨率。
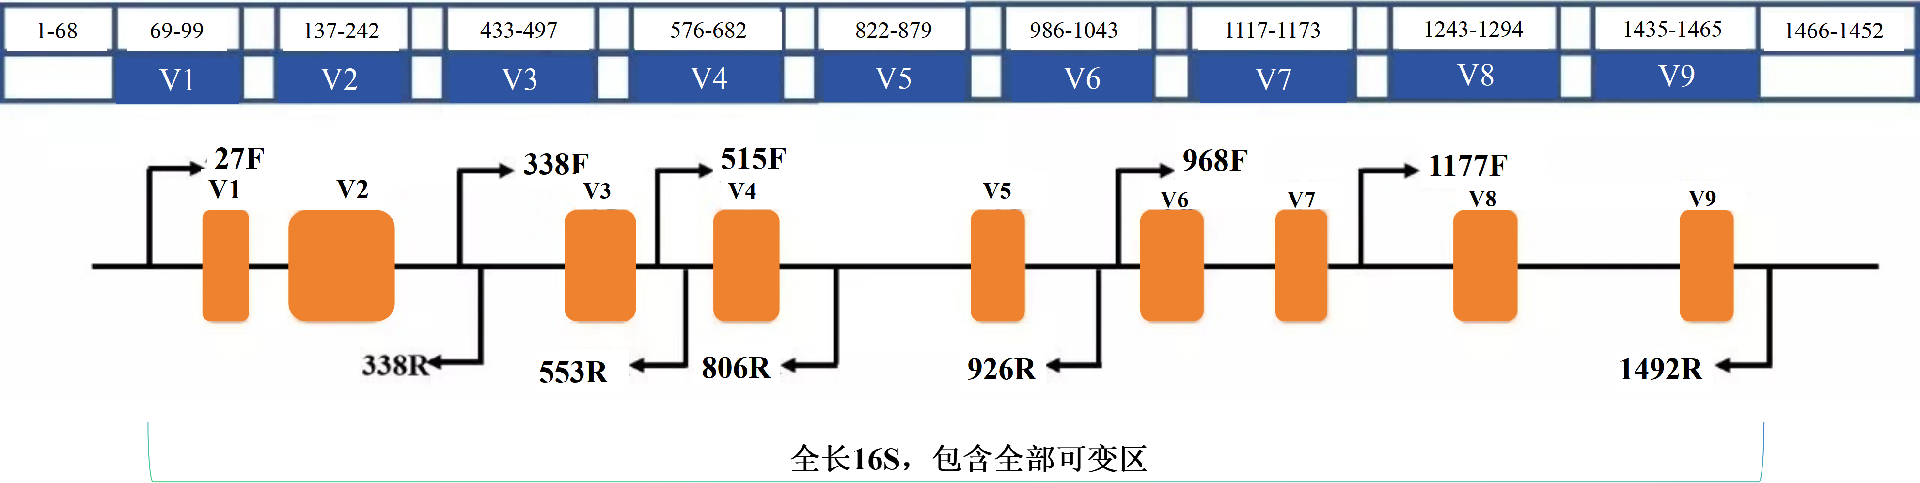 图2.16s rDNA全长(~1500bp)
1.3技术原理(PacBio Kinnex 16S rRNA试剂盒)
PacBio推出的Kinnex 16S rRNA试剂盒,提高了微生物测序通量。该试剂盒采用MAS-Seq技术,利用较长的HiFi读长,将多个全长16S扩增子串联成更长的单分子长片段,大幅度提升全长16S的测序通量。该试剂盒在Revio系统上,每张SMRT cell芯片上可产生60M Reads,与旧试剂盒相比,其通量提高了12倍。同时,新试剂盒最大可支持1536个混样测序。
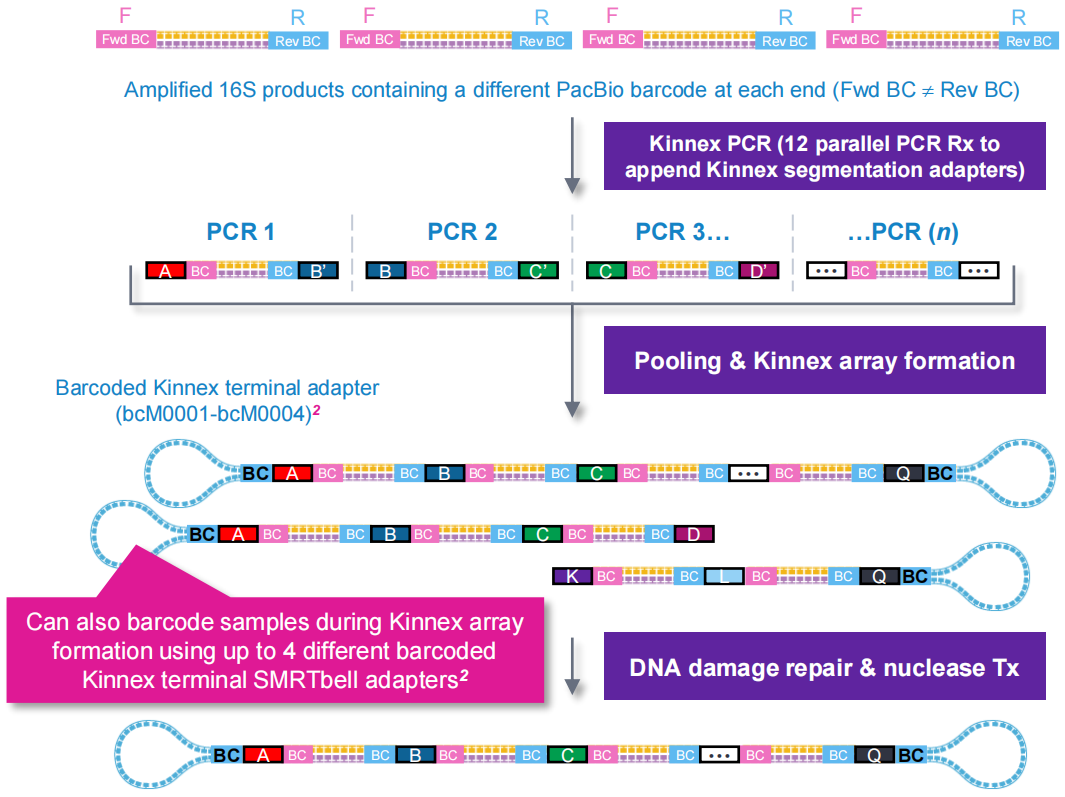
图3:Kinnex 16S rRNA试剂盒建库原理(图来自PacBio官方文档)
1.4实验流程
提取样品总DNA后,根据全长引物序列合成带有Barcode的特异引物,进行PCR扩增并对其产物进行纯化、定量和均一化形成测序文库(SMRT Bell),建好的文库先进行文库质检,质检合格的文库用 PacBio平台进行测序,并进行后续数据分析。

2.应用领域
Ø 鉴定环境样品中微生物在门、纲、目、科、属、种水平的分类;
Ø 检测环境样品中微生物在各分类水平上所占的相对比例即丰度;
Ø 比较不同处理样品中微生物群落结构的差异,各样品中优势菌种;
Ø 探索微生物群落和环境因子之间的相关关系。
3.技术路线
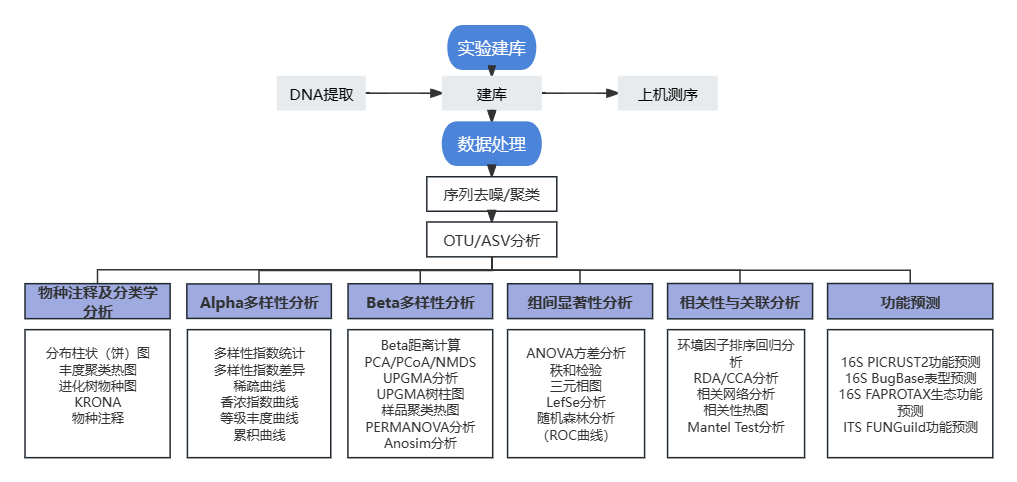
4.三代全长16S产品优势
1.长读长:三代16S测序跨越16S rRNA基因的全长序列,读长能达到15kb~20kb或更长的读长;而二代16S测序只覆盖部分可变区域,读长只能达到150~500bp。
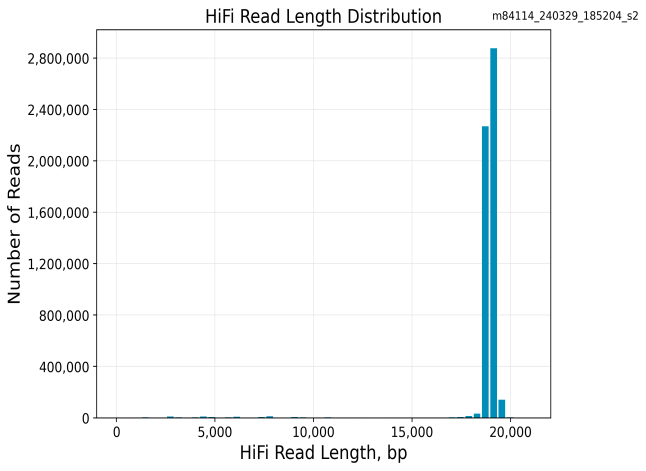
图4.基于PacBio Revio测序平台进行的三代16S测序的reads长度分布图。
2.更高的“种”水平注释率:三代全长16S测序可以覆盖V1-V9全长区域,实现“种”水平物种注释,且“种”级别物种注释率高;而二代16S测序仅能实现“属”水平物种注释,且属、种水平的未鉴定物种比例高。
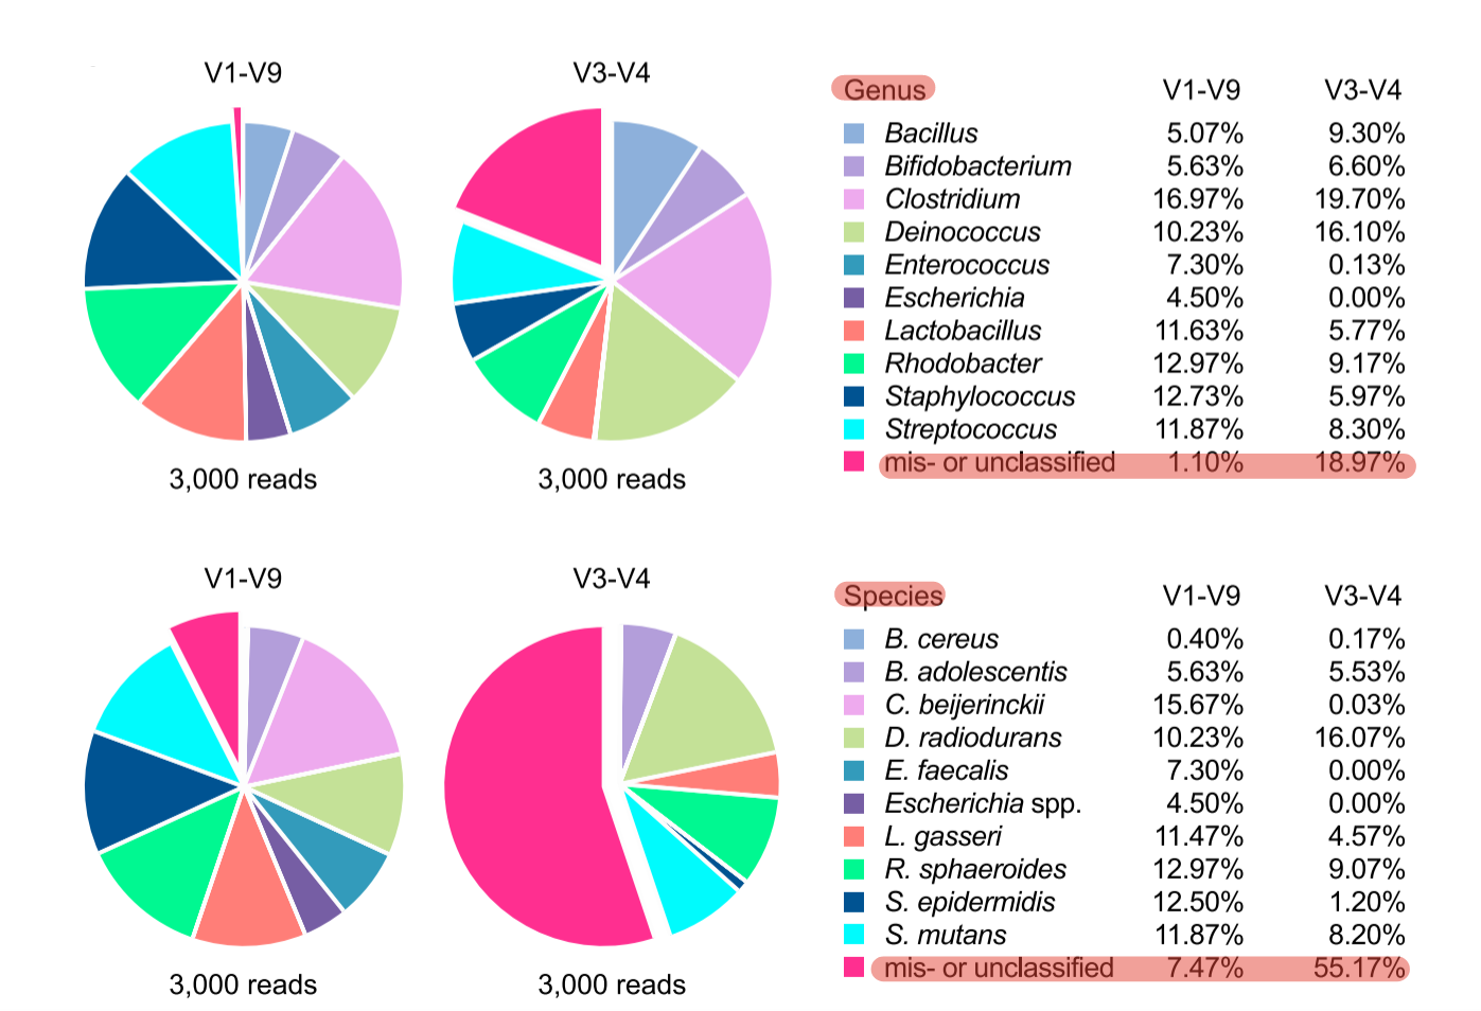
图5. 二代16s与三代全长16s未鉴定物种占比结果对比(图片引自文献【1】)
3.高准确度:PacBio HiFi、Illumina以及ONT的测序准确性测试,发现基于PacBio HiFi测序的准确性高达99%以上,明显高于Illumina和ONT。
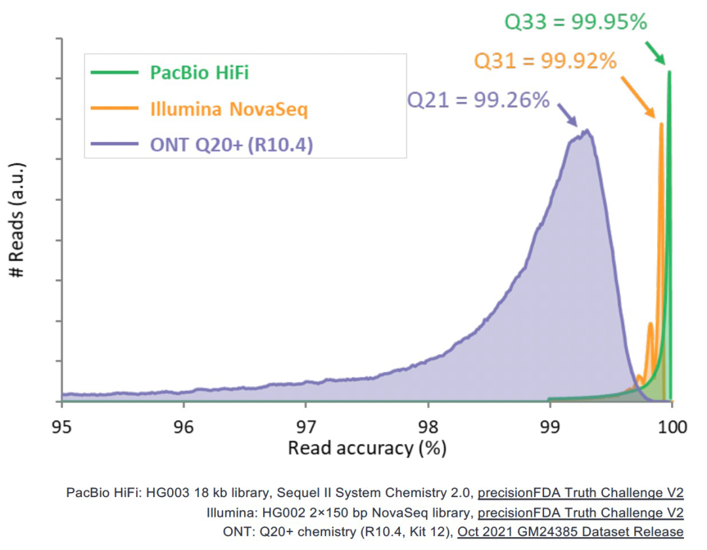
图6:PacBio HiFi、Illumina以及ONT测序准确性比较(图片引自PacBio官方)
4.高通量低成本:Revio系统支持60M SMRT cell,一张测序芯片上的零模波导孔(ZMW)提升至2500万个,其通量提高了12倍,且支持混样测序,大大降低了测序成本。
5.结果展示
康圣序源基于PacBio Revio测序平台以及Kinnex 16S rRNA试剂盒,混测275个样本进行三代全长16S测序。数据产出102.58G,HiFi Reads数5.48M。
表1:CCS数据统计
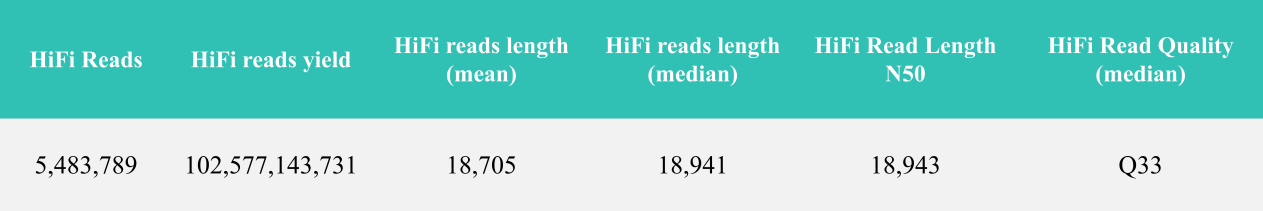
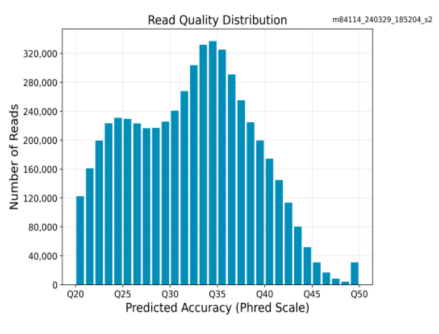
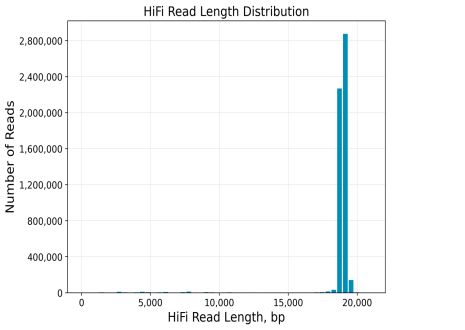
图7:测序准确性分布 图8:HiFi reads长度分布
2.文库串联连接效率:
本次项目将串联结构切割后共计得到64 M Segmented Reads (S-Reads),HiFi Reads平均串联结构单元11.77个,串联效率高达94.07%。
表2:S-Reads数据统计
|
S-Reads |
S-Reads yield/G |
Mean Length of S-Reads |
Percentage of Reads with Full Array |
Mean Array Size (Concatenation Factor) |
|
64,550,155 |
100.9 |
1,564 |
94.07 |
11.7711 |
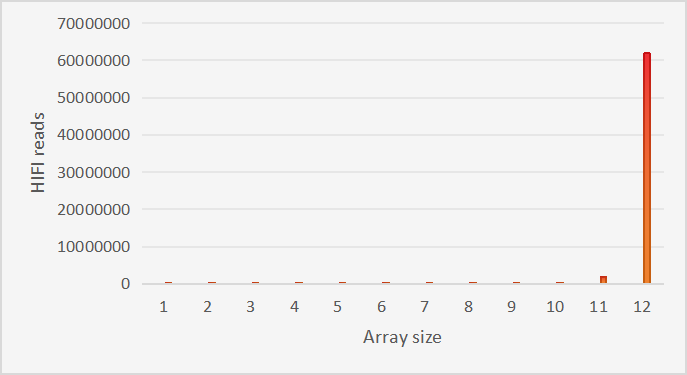
图9:HiFi Reads串联结构单元分布
3.拆分情况
拆分到275个样本,拆分得率高达99.62%,拆分HiFi Reads数为64,302,713,平均每个样本233,828,最少样本为44,674、最大样本为657,486。
表3:文库串联数据拆分统计
|
目标CCS |
2w |
3w |
5w |
|
样本数 |
117个 |
78个 |
80个 |
|
平均HiFi reads |
141964 |
346755 |
258075 |
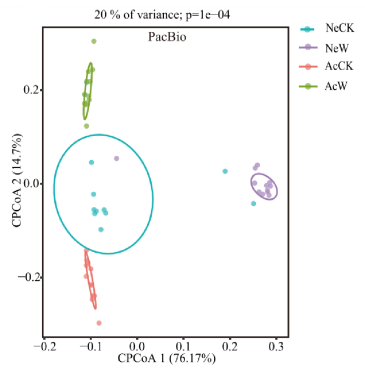
其他数据展示
|
|
|
|
|
|
物种注释丰度图 |
关联网络分析图 |
CPCoA分析图 |
物种丰度聚类热图 |
|
|
|
|
|
|
LEfSe分析图 |
PCA分析散点图 |
Procrustes相关性分析图 |
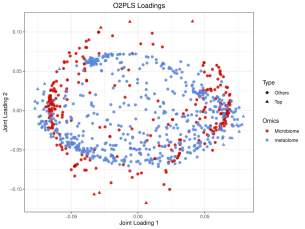
O2PLS 模型微生物和代谢物的载荷图 |
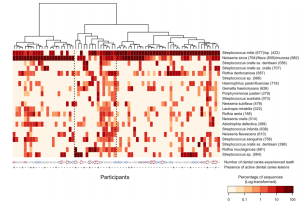
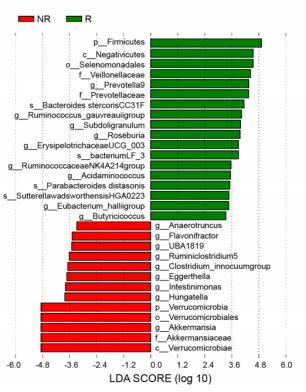
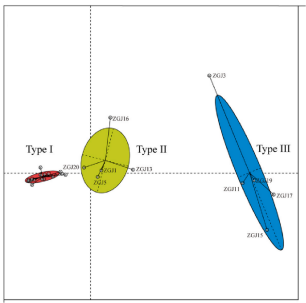
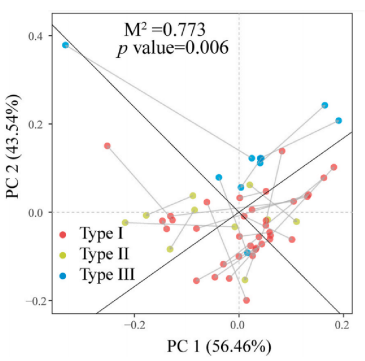
6.送样建议
|
样本类型 |
建议样本量 |
最低送样量 |
生物学重复 |
保存&运输条件 |
|
脑脊液 |
≥500μl |
200μl |
≥6个,临床样本≥30个 |
|
|
全血/血清/血浆 |
1~3ml |
200μl |
≥6个,临床样本≥30个 |
-80°C长期保存,干冰运输。避免反复冻融。 |
|
唾液 |
1~3ml |
200μl |
≥6个,临床样本≥30个 |
|
|
卵泡液 |
1~3ml |
200μl |
≥6个,临床样本≥30个 |
|
|
瘤胃液 |
1~3ml |
200μl |
≥6个,临床样本≥30个 |
|
|
尿液 |
≥2ml |
1ml |
≥6个,临床样本≥30个 |
|
|
乳汁 |
10~20ml |
5ml |
≥6个,临床样本≥30个 |
|
|
常规组织 |
0.5g~1g |
50mg |
≥6个,临床样本≥30个 |
|
|
肠道组织 |
0.5g~1g |
50mg |
≥6个,临床样本≥30个 |
|
|
粪便 |
0.5g~2g |
50mg |
≥6个,临床样本≥30个 |
|
|
肠道内容物 |
0.5g~2g |
50mg |
≥6个,临床样本≥30个 |
|
|
土壤/污泥/沉积物/腐殖质 |
3g |
0.5g |
≥6个,临床样本≥30个 |
|
|
DNA样本 |
总量≥150ng; 浓度≥5ng/ul; DNA无降解、无RNA/蛋白质污染等 |
|
≥6个,临床样本≥30个 |
|
|
水体滤膜 (孔径 0.22-0.45μm/直径 3-4cm) |
2~3张 |
1张 |
≥6个,临床样本≥30个 |
转自:康圣序源生物科技
- 本文固定链接: https://maimengkong.com/zu/2076.html
- 转载请注明: : 萌小白 2025年12月23日 于 卖萌控的博客 发表
- 百度已收录